

Identieke antwoorden en dubbele registraties
- View
Honderd registraties lijken op het eerste gezicht honderd afzonderlijke waarnemingen. Dat beeld verandert wanneer alle respondenten woordelijk dezelfde antwoorden geven en ieder antwoord bovendien zowel als gesprek als formulier is vastgelegd. Dan moet niet alleen naar de inhoud van de bevindingen worden gekeken, maar ook naar de manier waarop de gegevensverzameling is opgebouwd. In deze les onderzoek je vijf kenmerken die de interpretatie beperken: identieke antwoorden, minimale variatie, sjabloonmarkeringen, dubbele registraties en herhaling van de volledige gegevensverzameling.
Wanneer honderd antwoorden hetzelfde klinken
De eerdere lessen behandelden de inhoudelijke patronen in de antwoorden, zoals versnipperde informatie en late ketensignalen. Nu staat een andere vraag centraal: hoeveel zelfstandige variatie bevatten de onderliggende gegevens eigenlijk?
Woordelijk gelijke antwoorden
De antwoorden van alle respondenten zijn woordelijk gelijk. Dat gaat verder dan inhoudelijke overeenstemming. Respondenten kunnen hetzelfde probleem herkennen en toch andere voorbeelden, formuleringen of accenten gebruiken. Bij woordelijke gelijkheid ontbreekt die natuurlijke variatie.
Daardoor kunnen de registraties niet zonder meer worden gelezen als honderd afzonderlijk geformuleerde ervaringen. De inhoud kan nog steeds herkenbare operationele signalen bevatten, maar het aantal registraties zegt dan weinig over de hoeveelheid unieke informatie. Het onderscheid tussen een antwoord dat honderd keer voorkomt en honderd onafhankelijk geformuleerde antwoorden is hier essentieel.
Variatie beperkt tot divisienaam en functietitel
De geregistreerde verschillen blijven beperkt tot twee kenmerken:
-
de naam van de divisie;
-
de functietitel van de respondent.
De inhoudelijke antwoorden veranderen niet mee. De registratie wekt daarmee de indruk van spreiding over divisies en rollen, terwijl binnen de antwoorden geen bijbehorende inhoudelijke verschillen zichtbaar zijn.
Dat betekent bijvoorbeeld dat niet uit deze gegevens kan worden afgeleid hoe een bepaald onderwerp door verschillende functies is beschreven. De functietitels verschillen wel, maar de antwoordtekst biedt geen eigen formuleringen of rolgebonden voorbeelden waarmee zulke verschillen onderzocht kunnen worden. Hetzelfde geldt voor de divisies: de naam verandert, maar de inhoud levert geen afzonderlijke divisieperspectieven op.
Signalen van een vast sjabloon
Naast de woordelijke gelijkheid bevatten de antwoorden sjabloonmarkeringen. Zulke markeringen wijzen erop dat de registraties volgens een vast patroon zijn opgebouwd. In combinatie met identieke antwoordteksten versterken ze het beeld dat dezelfde inhoud herhaaldelijk is gebruikt.
De drie kenmerken moeten gezamenlijk worden gelezen:
- alle respondenten hebben woordelijk gelijke antwoorden;
- alleen divisienaam en functietitel variëren;
- in de antwoorden zijn sjabloonmarkeringen aanwezig.
Geen van deze kenmerken levert extra inhoudelijke variatie op. Samen laten ze zien dat de omvang van het bestand niet gelijkstaat aan een even grote hoeveelheid unieke respondentinformatie.
Het gaat daarbij om een beoordeling van de gegevensstructuur, niet om een nieuwe inhoudelijke beoordeling van de vijf kernbevindingen. De problemen uit Section 2 hoeven hier dus niet opnieuw te worden uitgelegd. De kritische vraag is of de registraties voldoende onafhankelijke onderbouwing bieden om de breedte en verschillen binnen die problemen vast te stellen.
Eén respondent, twee vastleggingen
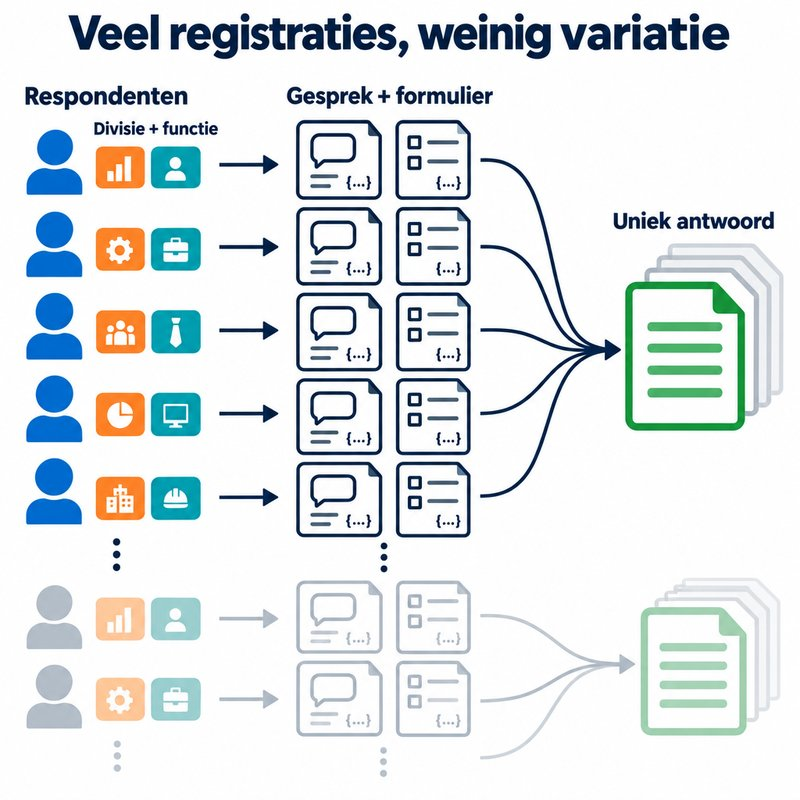
Iedere respondent is zowel als gesprek als formulier geregistreerd. Daardoor zijn er twee vastleggingen per respondent.
Die dubbele registratie mag niet automatisch als twee afzonderlijke reacties worden behandeld. Een gesprek en een formulier kunnen verschillende informatiebronnen zijn als ze aantoonbaar verschillende inhoud bevatten. In deze gegevensverzameling staat echter de dubbele vastlegging zelf centraal: dezelfde respondent komt in beide vormen terug.
Bij het beoordelen van de omvang moet daarom onderscheid worden gemaakt tussen:
-
het aantal respondenten;
-
het aantal registraties;
-
het aantal unieke antwoorden.
Deze aantallen betekenen niet hetzelfde. Twee registraties van één respondent vormen niet vanzelf twee onafhankelijke perspectieven. En wanneer de antwoordteksten van alle respondenten identiek zijn, vertegenwoordigt een groot aantal registraties evenmin een overeenkomstig groot aantal unieke formuleringen.
Herhaling van de volledige gegevensverzameling
De dubbele vastlegging blijft niet beperkt tot enkele losse antwoorden. De volledige gegevensverzameling wordt herhaald. Daarmee ontstaat een stapeling van herhaling:
- dezelfde inhoud komt bij alle respondenten terug;
- de inhoud varieert alleen in divisienaam en functietitel;
- sjabloonmarkeringen blijven in de antwoorden zichtbaar;
- iedere respondent is als gesprek én als formulier vastgelegd;
- hierdoor wordt de volledige verzameling nogmaals geregistreerd.
Dit is belangrijk bij het lezen van totalen. Een omvangrijk bestand kan bestaan uit veel rijen of documenten, terwijl de hoeveelheid unieke inhoud veel kleiner is. Daarom moeten het aantal bestanden, het aantal registraties en het aantal zelfstandige antwoorden uit elkaar worden gehouden.
De bevinding dat de volledige gegevensverzameling is herhaald, is dus niet alleen een administratief detail. Ze beïnvloedt hoe de omvang van het onderzoek moet worden begrepen. Het bestand toont een brede formele registratie, maar de antwoordteksten laten nauwelijks inhoudelijke variatie zien.
De vijf controlepunten naast elkaar
| Controlepunt | Wat in de gegevens zichtbaar is | Waarom dit aandacht vraagt |
|---|---|---|
| Woordelijk gelijke antwoorden | Alle respondenten hebben dezelfde antwoordtekst | Het aantal registraties is niet gelijk aan het aantal unieke formuleringen |
| Beperkte variatie | Alleen divisienaam en functietitel verschillen | Inhoudelijke verschillen tussen divisies en rollen zijn niet zichtbaar |
| Sjabloonmarkeringen | Antwoorden bevatten kenmerken van een vast format | Dit ondersteunt het beeld van hergebruikte antwoordteksten |
| Dubbele vastlegging | Iedere respondent staat als gesprek en formulier geregistreerd | Twee registraties betekenen niet automatisch twee afzonderlijke reacties |
| Volledige herhaling | De hele gegevensverzameling komt dubbel voor | De technische omvang van het bestand kan de unieke inhoud overschatten |
Onderzoek de opbouw van het gegevensbestand
1. Onderscheid respondenten, registraties en antwoorden
Een respondent staat eenmaal als gesprek en eenmaal als formulier geregistreerd. Beide registraties bevatten dezelfde antwoordtekst.
Beantwoord:
-
Hoeveel respondenten zijn er?
-
Hoeveel registraties zijn er?
-
Hoeveel unieke antwoordteksten zijn er?
-
Welk van deze drie aantallen beschrijft de inhoudelijke variatie het best?
2. Analyseer de zichtbare verschillen
Vergelijk twee registraties met verschillende divisienamen en functietitels, maar met woordelijk gelijke antwoorden.
Noteer afzonderlijk:
-
welke velden verschillen;
-
welke inhoud gelijk blijft;
-
welke informatie nodig zou zijn om een werkelijk verschil tussen de twee rollen of divisies zichtbaar te maken;
-
waarom alleen een andere functietitel geen afzonderlijk perspectief bewijst.
3. Breng de herhaling in kaart
Teken een eenvoudig schema van de gegevensstructuur:
respondent → gesprek + formulier → identieke antwoordtekst
Breid het schema daarna uit met de organisatiebrede herhaling. Markeer daarin:
-
de variabele divisienaam;
-
de variabele functietitel;
-
de sjabloonmarkeringen;
-
de dubbele registratie;
-
de herhaling van de volledige verzameling.
Sluit af met één zin waarin je uitlegt waarom een groot aantal registraties niet automatisch een grote hoeveelheid unieke informatie betekent.